
前回の記事では、ソフトウェアの理想と、物理アーキテクチャの泥臭い現実について書いた。
世の中では「優れたAIモデルさえあれば、自動運転は完成する」と語られることも多い。しかし、AIが弾き出したデジタルな数値を、モーターを回す物理的な力へと変換する統合(インテグレーション)の過程には、無数の「摩擦」が存在する。
そのことを最もシンプルな形で示すため、本記事では自動運転の最小構成をゼロから作る全手順を公開する。カメラ画像から操作を直接推論するEnd-to-End(E2E)のAIをPython(PyTorch)で学習させ、その結果をBluetoothで下位のArduinoへ伝え、ミニカーを実際に走らせるまでの一連の流れだ。
- 実車と同じ「AI用コンピューター」と「制御用マイコン」の分離を、ミニカーで再現する方法
- データ収集・学習・推論まで、そのまま動かせるPythonとArduinoのコード
- 作ってみて初めて見える「遅延」「照明の変化」「データの偏り」という3つの摩擦
全体像:4つのフェーズ
作業は、次の4つのフェーズで進める。
- ハードウェアの構築:AIを動かすPCと、モーターを動かすArduinoを分けて組む
- データ収集:人間がミニカーを操縦し、「カメラ画像」と「操作」のペアを集める
- 学習:集めたデータで、画像から操作を当てるAIを育てる
- 推論と走行:学習したAIにミニカーを運転させる
ミニカーの各部品は、実車の構成と次のように対応している。
| 役割 | 実車では | ミニカーでは |
|---|---|---|
| 認知(目) | 車載カメラ | スマホのカメラ |
| 判断(頭脳) | AI処理用のSoC(ADAS ECU) | PC上のPython(PyTorch) |
| 命令の伝送 | CAN、車載Ethernet | Bluetooth(HC-05) |
| 操作(手足) | 車両制御用のMCU (パワトレ、ブレーキのECU) | Arduino UNO |
| 安全の見張り役 | 冗長センサー、安全監視 | 超音波センサー(HC-SR04) |
Phase 1:ハードウェアとアーキテクチャの構築
まずは、「重いAI処理を行う上位のSoC」と「リアルタイムに制御する下位のMCU」を分けた、今の実車に近いアーキテクチャを組む。
| 役割 | 使う部品 |
|---|---|
| MCU(下位制御) | Arduino UNO R3 |
| SoC(上位判断) | Pythonを動かすPC(GPU搭載なら学習が速い) |
| センサー(認知) | スマートフォン(IP Webcamアプリで映像を配信)+スマホマウント |
| フェイルセーフ | 超音波センサー HC-SR04 |
| 通信モジュール | Bluetoothモジュール HC-05 |
| アクチュエーター | モータードライバー L298N + DCモーター×2 |
| モーター用電源 | 単3電池4本用の電池ボックス |
- モーターの電源はArduinoと分ける:L298Nには、Arduinoとは別の電池(単3電池4本など)から電気を送る。モーターが回り始めるときの大きな電流で電圧が下がり(ブラウンアウト)、Arduinoが再起動を繰り返す原因になる。
- GNDは共通に:電源を分けても、Arduino、L298N、電池のGNDはつないでおく。
- HC-05の受信ピンは3.3V:ArduinoのTX(5V)からつなぐときは、抵抗で電圧を下げる。
- 書き込み時はHC-05を外す:Arduinoの0・1番ピンにつないだままだと、PCからプログラムを書き込めない。
- モーターのノイズ対策:DCモーターの端子に0.1μFのコンデンサをはさむと、Arduinoの誤動作を減らせる。
実際に組み上げたミニカーの配線は、次の写真のとおりだ。部品の配置や配線の取り回しの参考にしてほしい。
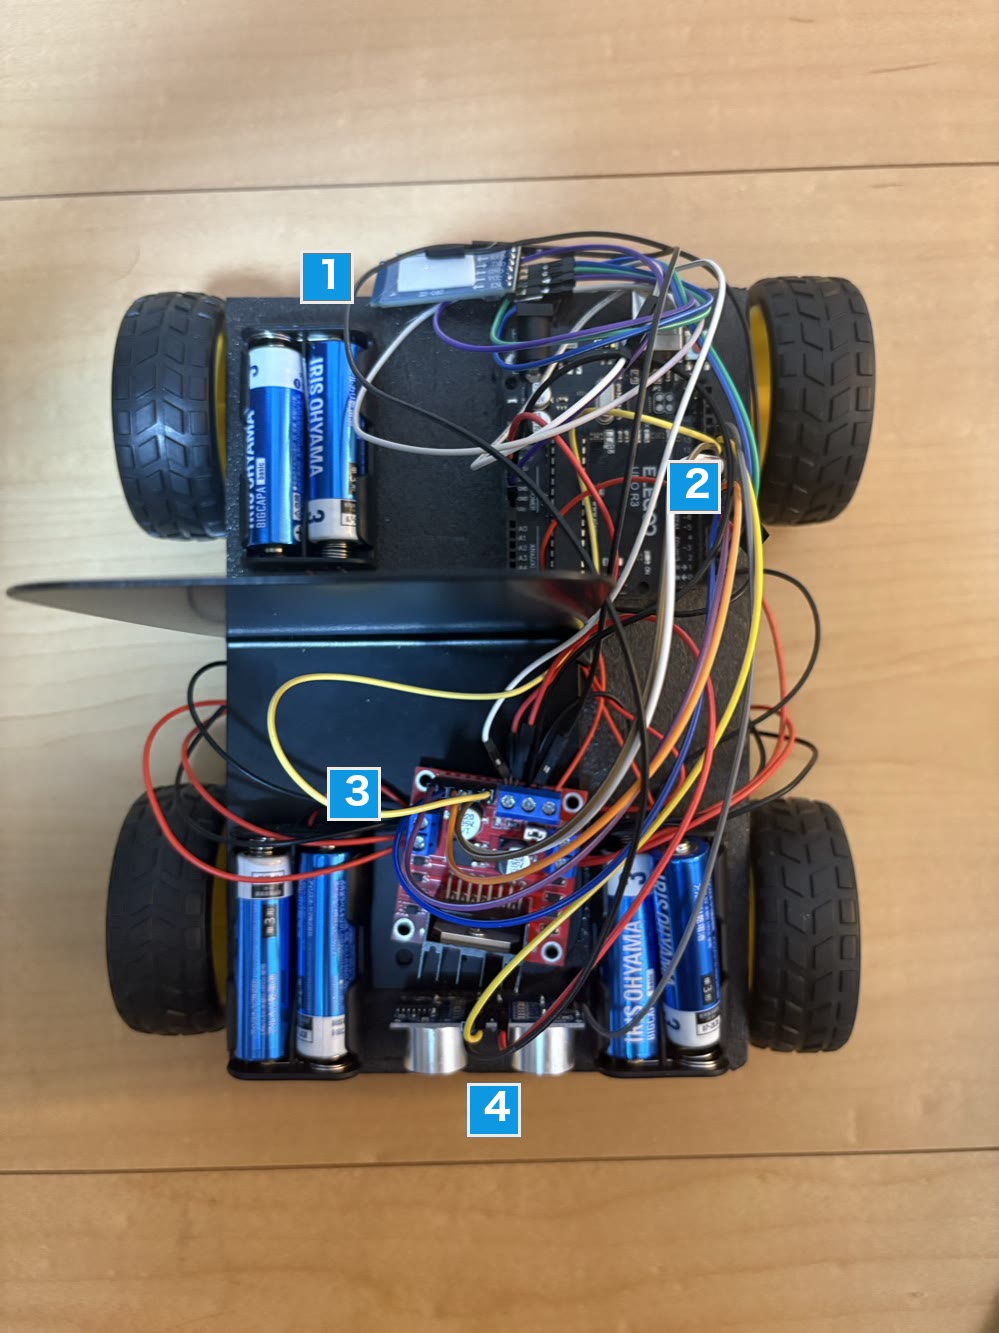
Arduinoには、PCからの命令(F:前進、L:左、R:右、S:停止)を受け取ってモーターを動かすプログラムを書き込む。ここで大事なのは、PCの判断よりも優先する安全装置を2つ、Arduinoの中だけで完結させていることだ。
// --- Arduino側:命令の受信と、独立したフェイルセーフ ---
const int TRIG = 9, ECHO = 10;                 // 超音波センサー HC-SR04
const int IN1 = 4, IN2 = 5, IN3 = 6, IN4 = 7;  // モータードライバー L298N
const int STOP_DISTANCE_CM = 20;               // これより近いと強制停止
const unsigned long CMD_TIMEOUT_MS = 300;      // 命令がこの時間届かなければ停止

char command = 'S';
unsigned long lastCmdMs = 0;

void setup() {
  Serial.begin(9600);  // HC-05は0・1番ピン(ハードウェアシリアル)に接続
  pinMode(TRIG, OUTPUT);
  pinMode(ECHO, INPUT);
  pinMode(IN1, OUTPUT); pinMode(IN2, OUTPUT);
  pinMode(IN3, OUTPUT); pinMode(IN4, OUTPUT);
  drive(LOW, LOW, LOW, LOW);
}

long readDistanceCm() {
  digitalWrite(TRIG, LOW);  delayMicroseconds(2);
  digitalWrite(TRIG, HIGH); delayMicroseconds(10);
  digitalWrite(TRIG, LOW);
  long us = pulseIn(ECHO, HIGH, 25000);  // 25msで打ち切る(初期値の1秒だと制御が止まる)
  if (us == 0) return -1;                // 反射が返ってこない
  return us / 58;                        // 往復の時間 → 距離[cm]
}

void drive(int a, int b, int c, int d) {
  digitalWrite(IN1, a); digitalWrite(IN2, b);
  digitalWrite(IN3, c); digitalWrite(IN4, d);
}

void loop() {
  // 1. 上位(Python)からの命令を受け取る
  while (Serial.available() > 0) {
    command = Serial.read();
    lastCmdMs = millis();
  }

  // 2. フェイルセーフ①:障害物が近ければ、上位の命令を無視して停止
  long d = readDistanceCm();
  if (d > 0 && d < STOP_DISTANCE_CM) {
    drive(LOW, LOW, LOW, LOW);
    return;
  }

  // 3. フェイルセーフ②:通信が途絶えたら停止(ウォッチドッグ)
  if (millis() - lastCmdMs > CMD_TIMEOUT_MS) {
    drive(LOW, LOW, LOW, LOW);
    return;
  }

  // 4. 上位の判断どおりに動かす(左右は配線によって逆になることがある)
  switch (command) {
    case 'F': drive(HIGH, LOW, HIGH, LOW); break;  // 前進
    case 'L': drive(LOW, LOW, HIGH, LOW);  break;  // 左旋回(右のモーターだけ回す)
    case 'R': drive(HIGH, LOW, LOW, LOW);  break;  // 右旋回(左のモーターだけ回す)
    default:  drive(LOW, LOW, LOW, LOW);   break;  // 停止
  }
}- フェイルセーフ①(障害物):超音波センサーで20cm以内に物があれば、AIが「前進」と言っていても止まる。
- フェイルセーフ②(通信の途絶):PCからの命令が0.3秒届かなければ止まる。いわゆるウォッチドッグだ。これがないと、Bluetoothが切れた瞬間の命令が「前進」だった場合、ミニカーは走り続けてしまう。
pulseIn()の待ち時間:初期設定では、反射が返ってこないと最大1秒止まる。その間は命令の受信も止まるので、25ミリ秒で打ち切っている。
PC側の3つのスクリプトで共通して使う部品(AIモデルの形、画像の前処理、接続先)は、1つのファイルにまとめておく。
# --- 共通部品 (e2e_common.py):モデル・前処理・接続設定 ---
import torch.nn as nn
from torchvision import transforms

STREAM_URL = "http://192.168.x.x:8080/video"  # IP Webcamの映像配信URL
BT_PORT = "/dev/cu.HC-05"                     # macOSの例(Windowsは "COM5" など)
LABELS = ["F", "L", "R"]                      # 前進・左・右


class E2E_Model(nn.Module):
    """NVIDIAのPilotNetを小さくした構成のCNN。画像から3つの操作のどれかを出す"""

    def __init__(self):
        super().__init__()
        self.conv_layers = nn.Sequential(
            nn.Conv2d(3, 24, kernel_size=5, stride=2), nn.ReLU(),
            nn.Conv2d(24, 36, kernel_size=5, stride=2), nn.ReLU(),
            nn.Conv2d(36, 48, kernel_size=5, stride=2), nn.ReLU(),
            nn.Flatten(),
        )
        self.fc_layers = nn.Sequential(
            nn.Linear(48 * 27 * 37, 100), nn.ReLU(),  # 240×320の入力で 27×37 になる
            nn.Linear(100, len(LABELS)),
        )

    def forward(self, x):
        return self.fc_layers(self.conv_layers(x))


# 学習時と推論時で、必ず同じ前処理を使う
preprocess = transforms.Compose([
    transforms.Resize((240, 320)),
    transforms.ToTensor(),
    transforms.Normalize(mean=[0.485, 0.456, 0.406], std=[0.229, 0.224, 0.225]),
])
Phase 2:データ収集(人間の運転を記録する)
End-to-EndのAIは、ゼロからは何も学ばない。人間の運転操作をまねさせる「行動模倣学習(Behavioral Cloning)」のために、「カメラ画像」と「そのとき人間がした操作」のペアを大量に集める必要がある。
そこで、PCのキーボードでミニカーをラジコンのように操縦しながら、映像と操作を同時に保存するスクリプトを走らせる。
# --- Phase 2:データ収集 (data_collection.py) ---
# W:前進 / A:左 / D:右 / S:停止 / Q:終了(映像のウィンドウを選択した状態で押す)
import os
import time

import cv2
import serial

from e2e_common import BT_PORT, STREAM_URL

os.makedirs("dataset/images", exist_ok=True)
log_file = open("dataset/driving_log.csv", "a")  # 追記:何回かに分けて集められる

cap = cv2.VideoCapture(STREAM_URL)
cap.set(cv2.CAP_PROP_BUFFERSIZE, 1)  # 古いフレームをためこまない
bt = serial.Serial(BT_PORT, 9600, timeout=0)
time.sleep(2)

KEYS = {ord("w"): "F", ord("a"): "L", ord("d"): "R", ord("s"): "S"}
action = "S"
frame_count = len(os.listdir("dataset/images"))  # 続きの番号から保存する

try:
    while True:
        ok, frame = cap.read()
        if not ok:
            continue

        cv2.imshow("Data Collection", frame)
        key = cv2.waitKey(1) & 0xFF
        if key == ord("q"):
            break
        action = KEYS.get(key, action)  # 押されたキーで操作を切り替える

        # Arduinoへ毎フレーム送る(ラジコンとして動かしつつ、生存確認を兼ねる)
        bt.write(action.encode())

        # 停止中以外の「画像と操作」のペアを保存する
        if action != "S":
            img_name = f"frame_{frame_count:06d}.jpg"
            cv2.imwrite(f"dataset/images/{img_name}", frame)
            log_file.write(f"{img_name},{action}\n")
            frame_count += 1
finally:
    bt.write(b"S")
    log_file.close()
    cap.release()
    bt.close()
    cv2.destroyAllWindows()
このスクリプトでコースを何周も走らせ、数千枚の画像とラベル(操作)のペアを作る。良いデータを集めるコツは3つある。
- 「立て直す運転」も記録する:うまく走った映像だけだと、AIはコースから外れかけたときにどうすればいいかを知らない。わざと少しずれた位置から、戻る操作も記録しておく。
- 時間帯や照明を変えて集める:後で説明する「照明の変化」に強くなる。
- キー入力はOpenCVで受け取る:よく使われる
keyboardライブラリは、macOSでは管理者権限がないと動かないことが多い。今回は映像のウィンドウでW・A・D・Sキーを押す方式にした。
Phase 3:End-to-End AIモデルの学習(PyTorch)
集めたデータで、画像を入力すると「F(前進)、L(左)、R(右)」のどれかを答える畳み込みニューラルネットワーク(CNN)を学習させる。モデルの形は、NVIDIAが2016年に発表したE2E自動運転のモデル「PilotNet」を小さくしたものだ。
実車で開発されているE2Eモデルははるかに巨大で、Transformerなどの新しい仕組みも使われている。それでも、「画像から運転操作を直接学ぶ」という根本の発想は同じだ。
# --- Phase 3:学習 (train_model.py) ---
import pandas as pd
import torch
import torch.nn as nn
from PIL import Image
from torch.utils.data import DataLoader, Dataset, Subset
from torchvision import transforms

from e2e_common import LABELS, E2E_Model, preprocess

# 照明の違いに強くするため、学習時だけ明るさ・色をランダムに揺らす
augment = transforms.ColorJitter(brightness=0.4, contrast=0.4, saturation=0.3)


class DrivingDataset(Dataset):
    def __init__(self, csv_file, img_dir, train):
        self.data = pd.read_csv(csv_file, names=["image", "label"])
        self.img_dir = img_dir
        self.train = train

    def __len__(self):
        return len(self.data)

    def __getitem__(self, idx):
        name, label = self.data.iloc[idx]
        image = Image.open(f"{self.img_dir}/{name}").convert("RGB")
        if self.train:
            image = augment(image)
        return preprocess(image), LABELS.index(label)


train_data = DrivingDataset("dataset/driving_log.csv", "dataset/images", train=True)
val_data = DrivingDataset("dataset/driving_log.csv", "dataset/images", train=False)
print("ラベルの内訳:", train_data.data["label"].value_counts().to_dict())  # 偏りを確認する

n_val = max(1, len(train_data) // 5)  # 2割を検証用に取り分ける
order = torch.randperm(len(train_data)).tolist()
train_set, val_set = Subset(train_data, order[n_val:]), Subset(val_data, order[:n_val])
train_loader = DataLoader(train_set, batch_size=32, shuffle=True)
val_loader = DataLoader(val_set, batch_size=32)

device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
model = E2E_Model().to(device)
criterion = nn.CrossEntropyLoss()
optimizer = torch.optim.Adam(model.parameters(), lr=0.001)

for epoch in range(10):
    model.train()
    for images, labels in train_loader:
        images, labels = images.to(device), labels.to(device)
        optimizer.zero_grad()
        loss = criterion(model(images), labels)
        loss.backward()
        optimizer.step()

    # 学習に使っていないデータで、正解率を確かめる
    model.eval()
    correct = 0
    with torch.no_grad():
        for images, labels in val_loader:
            preds = model(images.to(device)).argmax(1)
            correct += (preds == labels.to(device)).sum().item()
    print(f"Epoch {epoch + 1}: loss {loss.item():.4f}, 検証の正解率 {correct / n_val:.1%}")

torch.save(model.state_dict(), "e2e_model.pth")
print("e2e_model.pth に保存しました")- 明るさをわざと揺らして学習する:
ColorJitterで、学習のたびに画像の明るさや色を少しずつ変えている。照明の変化に強くするための工夫だ。 - 検証用データで正解率を見る:学習に使っていない2割のデータで、本当に見分けられているかを確かめる。
- ラベルの内訳を必ず確認する:理由は「摩擦③」で説明する。
この工程で、人間の運転のくせを写し取った推論モデル(e2e_model.pth)ができあがる。
Phase 4:推論と走行(デプロイ)
最後に、学習済みのモデルを読み込み、カメラ映像からリアルタイムに操作を決めて、ArduinoへBluetoothで送る。
# --- Phase 4:推論と制御 (inference.py) ---
import time

import cv2
import serial
import torch
from PIL import Image

from e2e_common import BT_PORT, LABELS, STREAM_URL, E2E_Model, preprocess

device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
model = E2E_Model().to(device)
model.load_state_dict(torch.load("e2e_model.pth", map_location=device))
model.eval()

cap = cv2.VideoCapture(STREAM_URL)
cap.set(cv2.CAP_PROP_BUFFERSIZE, 1)
bt = serial.Serial(BT_PORT, 9600, timeout=0)
time.sleep(2)

try:
    while True:
        ok, frame = cap.read()
        if not ok:
            break
        t0 = time.perf_counter()

        # OpenCVの画像(BGR)を、学習時と同じ形のテンソルに変換する
        rgb = Image.fromarray(cv2.cvtColor(frame, cv2.COLOR_BGR2RGB))
        x = preprocess(rgb).unsqueeze(0).to(device)

        # AIによる判断
        with torch.no_grad():
            action = LABELS[model(x).argmax(1).item()]

        bt.write(action.encode())  # 毎フレーム送る=Arduinoへの生存確認にもなる

        ms = (time.perf_counter() - t0) * 1000
        cv2.putText(frame, f"{action}  {ms:.0f} ms", (10, 30),
                    cv2.FONT_HERSHEY_SIMPLEX, 1, (0, 255, 0), 2)  # 判断と処理時間を表示
        cv2.imshow("Inference", frame)
        if cv2.waitKey(1) & 0xFF == ord("q"):
            break
finally:
    bt.write(b"S")  # どんな終わり方でも、最後に停止命令を送る
    cap.release()
    bt.close()
    cv2.destroyAllWindows()
このとき、下位のArduinoでは、Phase 1で書いた2つのフェイルセーフが独立して動き続けている。AIがどれだけ高度でも、最後の安全は物理に近い層(MCU側)で完結させる。これがアーキテクチャの鉄則だ。
【動画】AIが運転するミニカー
学習したAIが、スマホカメラの映像だけを頼りに部屋のコースを走る様子を撮影した。
アーキテクチャの壁:物理的な3つの摩擦
以上の手順でシステムは完成する。しかし実際に自律走行させてみると、必ず次の壁にぶつかるはずだ。
摩擦① 通信と処理の遅延
Pythonが画像を処理して「L(左)」と判断してから、Bluetooth経由でArduinoに届くまで、数十ミリ秒から数百ミリ秒の遅れが生じる。その間も、ミニカーは直進し続けてしまう。推論スクリプトでは、1フレームの処理時間を画面に表示するようにしているので、自分の環境で実際に測ってみてほしい。
実車に置き換えると、この遅れの重さがわかる。時速60kmなら、0.1秒の遅れで約1.7m進んでしまう。
摩擦② 照明が変わるだけで、AIは迷う(ドメインシフト)
学習したときは夕方、走らせるときは夜。部屋の照明が変わるだけで、AIの判断の精度は大きく落ちる。人間には同じ部屋に見えても、AIにとっては「見たことのない世界」になるからだ。学習時の環境と実際に使う環境のずれを、ドメインシフトと呼ぶ。
対策としては、時間帯や照明を変えてデータを集めることと、学習時に明るさをわざと揺らすことが有効だ。今回のコードにも、明るさを揺らす工夫を入れている。実車では、昼と夜、晴れと雨、国や地域の違いまで含めて、このずれと戦い続けることになる。
摩擦③ 正解率の高さにだまされる(データの偏り)
コースを走ると、操作の大半は「前進」になる。たとえばデータの7割が前進なら、AIは何も見ずに「前進」と答え続けるだけで、正解率は約7割になってしまう。数字だけ見れば学習できているようでも、カーブではまったく曲がれない。
学習スクリプトでラベルの内訳を表示しているのは、このためだ。カーブのデータを多めに集める、左右反転した画像を足して「左」と「右」を増やす、といった工夫で偏りをならす。
実車の現場でも、まったく同じことが起きている
ミニカーで起きた摩擦は、実車の開発現場で起きていることの縮図だ。
- 遅延 → カメラ映像を運ぶ高速伝送や車載Ethernetの帯域の確保、処理全体の時間設計
- ドメインシフト → 複数のセンサーを組み合わせるセンサーフュージョンによる、ノイズや見落としの補い合い
- フェイルセーフ → 安全監視を、AIとは独立したMCUに持たせる設計
これらはすべて、上位のAIモデルを「物理世界で安全に動かす」ための、泥臭いアーキテクチャ設計だ。
美しいAIのコードを書ける人は、これからますます増えていく。しかし、モーターのノイズや通信の途切れといった「物理の摩擦」まで理解し、システム全体を組み直せる人は、まだ多くない。
たかがおもちゃのミニカー。されど、自動運転のインテグレーションの本質は、すべてこの中にある。